Showing posts with label TimeSeries. Show all posts

Monday, January 26, 2015

Informix on Pi / Informix no Pi

IBM finally released the Pi version (original version here: http://informix-technology.blogspot.com/2015/01/informix-on-pi-informix-no-pi.html)


English version
A couple of weeks ago IBM discretely let us know that the Informix version for ARM V6 was available for download. It's accessible as a free developer edition on IBM site (Informix downloads) and only the usual site registration is required.
For those of you who may be wondering what is an ARM V6, it may be easier if I say it's the chip included in the well known SoC (System on a Chip) Raspberry Pi small computer.
For clarity I'm including a picture of my own, taken on top of a 20€ bill. The cost rounds 35€ plus some extras. It can be used for very small computer systems, as a controller for all sorts of DIY kits, as a media center solution, and now also as a database server, courtesy of IBM Informix development.

Accordingly to the machine notes it is designed to run on Raspbian (based on debian) which is widely used on the Raspberry Pi. But it may work on others. Raspian is one of the most used OS for Raspberry Pi and it's included in the NOOBS package so it's very easily accessible.

Please not that  ARM V6 is a limited CPU, and the Raspberry Pi itself has (depending on the models) 512MB of RAM. So this will not be your benchmark breaking machine. But if you need to add a database to a small project these specs are more than enough for Informix thanks to it's embedabillity.

The port includes most of the usual Informix functionality, including TimeSeries and the Spatial databalade, the new REST API etc.

Well worth checking!


Versão Portuguesa
Há um par de semanas atrás a IBM deixou saber de forma discreta que a versão para ARM V6 do Informix estava disponível para download. Está acessível como versão de desenvolvimento, de acesso gratuito no site da IBM (Informix downloads) sendo apenas necessário o habitual registo no site.
Para os que estiverem a pensar o que é um ARM V6, talvez seja mais fácil se eu disser que é o processador que vem incluído no bem conhecido SoC (Sistema num Chip) Raspberry Pi, um pequeno computador numa placa.
Para clareza estou a incluir uma imagem de um que possuo, neste caso tirada sobre uma nota de 20€. O seu custo é acima disso (uns 35€ + extras). Pode ser usado em pequenos sistemas computacionais, como controlador em kits "faça você mesmo" ou como media center, e a partir de agora como servidor de base de dados, cortesia do desenvolvimento IBM Informix.
 De acordo com as machine notes, foi desenhado para ser executado em Raspbian (baseado em debian), que é massivamente utilizado no Raspberry Pi. Mas poderá ser executado noutros. O Raspbian é um dos SOs mais usados no Raspberry Pi e vem incluído no pacote NOOBS, o que o torna muito facilmente acessível.

Note que o ARM V6 é um processador bastante limitado, e que o Raspberry Pi tem (dependendo dos modelos) 512MB de RAM. Isto não será portanto uma máquina para esmagar benchmarks. Mas se precisa de adicionar uma base de dados a algum dos seus projectos, estas especificações serão mais que suficientes para o Informix graças às suas conhecidas capacidades de embutimento.

O port incluí a maioria das habituais funcionalidades do Informix, incluindo TimeSeries e o datablade para informação Geo-Espacial, bem como a nova REST API etc.

Vale a pena ver!


Wednesday, October 29, 2014

Future... / Futuro...

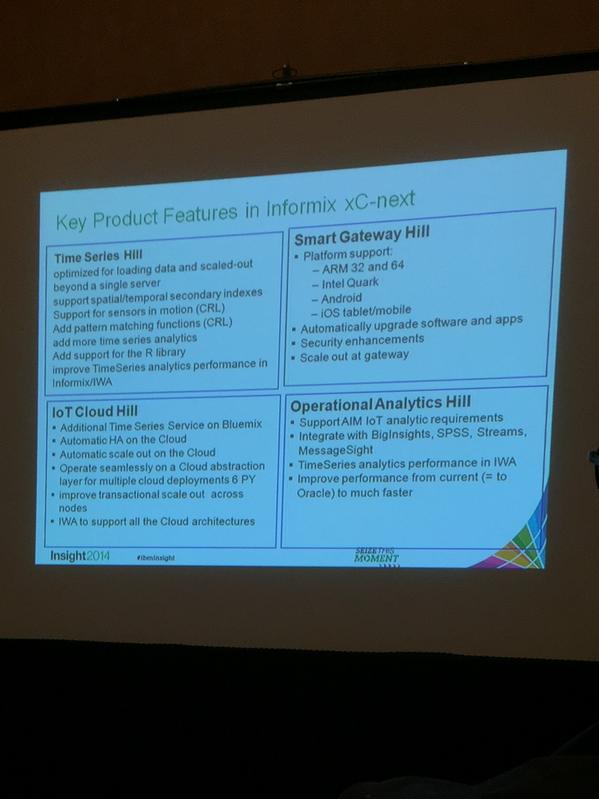
Directly from IBM Insight via Twitter, some future features (original version here)


English version
The image below was recently twitted by the oficial @IBM_Informix twitter account with the following comment:

" Key Product Features in #Informix xC - Next coming within the next 12 months or so. #IoT #ibminsight "

It looks brave and bright... I call for your attention to the top right corner... And naturally the work started for multi-tenancy will probably continue

Versão Portuguesa
A imagem abaixo foi publicada recentemente no Twitter pela conta oficial do Informix no Twitter com o seguinte comentário:

" Key Product Features in #Informix xC - Next coming within the next 12 months or so. #IoT #ibminsight "

Parece ser um futuro desafiador e claro... chamo a sua atenção para o canto superior direito... E naturalmente será de esperar a continuação do trabalho iniciado com o multi-tenant


Embedded image permalink


Thursday, September 25, 2014

Get smarter! / Seja "smarter"!

A new success story about #Informix and Internet Of Things (#iot). Congratulations Shaspa
Original version here.


English version
IBM has just published a new success story involving a partner deeply related in the Internet Of Things hot topic. You can read it here: http://www-03.ibm.com/software/businesscasestudies/us/en/corp?synkey=W874536K43808P17
As you'd expect, because you're reading it in an Informix dedicated blog, and hopefully because you've read one of my last posts, it deeply refers to Informix. I already mentioned that we already provide an ARM port and that we're working on an Intel Quark port, and this partner is one of the driving forces behind it. As you can read from the story, they created small intelligent devices that can collect data from a lot of various sources and act as a gateway between those devices and a back end service.
Informix is used inside the devices and as the back end database. I can assume that some of the reasons for that are:

  • IBM Informix R&D team flexibility to create new ports whenever there's demand for it
  • The need for an enterprise class database fully supported
  • Extensibility features that allow special processing for time-series and geo-spatial data
  • Flexibility as an enterprise database and integration with other IBM software portfolio products like Cognos and SPSS
  • New flexible possibilities introduced recently in Informix like JSON and REST API
  • The recognized capabilities that make Informix a best fit for embedded environments
I honestly suggest reading the paper (not very big) as it contains the description of several examples of usages that are really interesting. They give us examples of how Internet Of Things can make our lives "smarter".
And of course... if I'm allowed the irony, this is another perfect example of how IBM and the market is "killing" Informix. New and innovative features for new uses and market requests. Exactly what you expect to see in a dying product as the competitors would like customers to believe.
Congratulations to Shaspa for their innovation capability and for breaking new ground.

Versão Portuguesa
A IBM publicou um novo caso de sucesso, envolvendo um parceiro muito ligado à Internet das  Coisas, um tópico quente hoje em dia. Pode lê-lo aqui: http://www-03.ibm.com/software/businesscasestudies/us/en/corp?synkey=W874536K43808P17
Como seria de esperar, porque está a ler um blog dedicado ao Informix, e eventualmente por ter lido um dos meus últimos artigos, isto está muito relacionado com o Informix. Já referi que atualmente já disponibilizamos uma versão para processadores ARM, e que estamos a trabalhar numa versão para Intel Quark. Este parceiro é uma das motivações para o fazer. Como pode ler na história completa, eles criaram um dispositivo inteligente que pode recolher dados de várias fontes e actuar como um gateway entre essas fontes e um serviço de retaguarda.
O Informix é usado dentro dos dispositivos e como a base de dados do serviço de suporte. Posso assumir que algumas das razões para a escolham tenham sido:
  • A flexibilidade da equipa de I&D da IBM Informix que disponibiliza o produto para novas plataformas sempre que há procura para tal
  • A necessidade de apostar numa base de dados de classe empresarial e totalmente suportada
  • As capacidades de extensibilidade que permitem processamento especial de dados time-series e geo-espaciais
  • Flexibilidade como base de dados empresarial e integração com outros produtos do leque de software como o Cognos e o SPSS
  • Novas funcionalidades que aumentam a flexibilidade e que foram introduzidas recentemente no Informix como o JSON e a REST API
  • As reconhecidas capacidades do Informix para correr em ambientes embebidos 
Honestamente sugiro a leitura do caso (não é longo) visto que contém descrições de vários exemplos de utilização que são realmente interessantes. Dão-nos um exemplo de como a Internet das Coisas pode tornar a nossa vida mais "inteligente"
E claro... se me é permitida a ironia, é outro exemplo perfeito de como a IBM e o mercado estão a "matar" o Informix. Novas e inovadoras funcionalidades para novos usos e pedidos do mercado. Exatamente o que se espera de um produto que está a morrer como a nossa concorrência gostaria que os clientes acreditassem.
Parabéns à Shaspa pela sua capacidade de inovação e por desbravar novos caminhos

Saturday, September 20, 2014

So many things on the Internet / Tantas coisas na Internet

This article is written in Englsih and Portuguese (original version here)
Este artigo está escrito em Inglês e Português (versão original aqui)


English version
If you've been paying attention, you'll easily recognize that the "Internet Of Things" or #IoT is "the" buzzword of the moment. You can follow the links to learn more about it, but in a very short summary, the hype is created because there are estimations that by 2020 we will have 26B devices (note that there are around 7B people on the planet and unfortunately many of them don't use any electronic device) connected to the Internet. Why? Many of these devices will be generating data that needs to be processed. How? The devices tend to be connected, and the "cloud" seems to be the future in terms of all this data processing. This data can be related to the following uses among many others:

  • Location based services
  • Home automation
  • Smarter planet/cities initiatives like air quality monitoring, traffic control, security etc.
  • Weather measurements
  • Supply chain related (logistics)
  • Fitness data
  • Smart meters
  • Sensors of all kinds
Well... this is great... apart from the expected privacy and security questions (which are already present today) it may help us improve the resource usage and quality of life,besides helping us to interact in ways that our grandfathers couldn't dream off. But what this has to do with Informix you may ask? Lets not be innocent. All this hype and buzz means business opportunities. And IBM and it's partners are very aware of this. And all this data generation and processing requires quality IT systems. Some relevant areas are:
  • Cloud usage
  • Embedded systems
  • Spatial capabilities
  • Timeseries data
Sounds familiar? Informix is very strong (not to say unique) in all these aspects. And if you check the recent improvements you'll see that's one of the focus for Informix R&D.
Let's check each of them:
  1. Cloud usage
    Informix provides some of the database services in IBM Bluemix. The unique capabilities of autonomics, low maintenance, the new multi-tenancy features and many other "small" improvements we can see in the recent fixpacks
  2. Embedded systems
    I recently noticed we can now get regular access to the ARM (if you're not aware of Arm you probably have several of these processors around you, in your SmartPhone, Tablets etc.) port which was announced a few fixpacks ago. We're probably the first major commercial RDBMS product that runs on ARM (DB2, Oracle, SQL Server, Sybase etc. don't). If this was not enough, we're working on the port to Intel Quark as you can see from recent Intel blog post and the video from it's developer conference (around minute 37). Why are these ports important? Because it allows embedded systems developers to use a full featured commercial database with very reach capabilities like TimeSeries and Spatial on really little and low power consumption boards like the Intel Galileo, Cubieboard 2+ and many others (take a look at Shaspa gateway device)
  3. Spatial capabilities
    Hopefully you know that Informix ships with a free Spatial Datablade that allows the storage and processing of geographical data. In 12.10.xC3 we improved it by allowing Great Circle Calculations and coordinate transformations between different DATA (or maps). In other words this means we can operate on angular coordinates, which allows exact calculations on the round earth model. Previously we only supported 2D maps.
  4. TimeSeries capabilities
    Another Informix datablade that ships with our product allow the efficient storage and processing of TimeSeries data. And many of the IoT data is TimeSeries data. Regular measures from smart meters or sensors. Regular coordinate capture to allow vehicle tracking... One company that has been receiving a lot of attention from developers and analysts is TempoDB, the company behind the database with the same name. This database "only" provides TimeSeries data services on the cloud... something we can do with Informix besides all the regular SQL and traditional RDBMS features. And again, in recent fixpacks we've introduce several "discrete" features around these capabilities

So, if you're on to these sort of things keep an eye on the several social networks because the stream of information about this topics is immense. And keep in mind that your favorite database in right in the middle of this revolution.

Versão Portuguesa
Se tem estado atento, facilmente reconhecerá que a "Internet das coisas" ou #IoT é "o" "chavão" do momento. Pode seguir os links para aprender mais, mas num resumo muito rápido, o burburinho nasceu porque  se estima que em 2020 haverá 26B de dispositivos (note que há "apenas" cerca de 7B de pessoas no planeta e infelizmente a muitas delas não têm acesso a qualquer dispositivo eletrónico) ligados à Internet. Porquê? Muitos destes dispositivos estarão a gerar dados que carecem de ser processados. Como? Os dispositivos tenderão a estar ligados e a "nuvem" parece ser o futuro para o processamento da maioria destes dados. Estes dados poderão estar relacionados com estas utilizações, entre outras:
  • Serviços baseados em localização
  • Domótica
  • Planeta/cidades inteligentes em iniciativas relacionadas por exemplo com a qualidade do ar ou a gestão de tráfego
  • Medições meteorológicas
  • Mercado de retalho (logística)
  • Dados relacionados com atividade física lúdica
  • Contadores inteligentes
  • Sensores de todos os tipos
Bom... tudo isto parece ótimo... Fora as questões de privacidade e segurança (que já se colocam hoje), pode ajudar-nos a gerir melhor os recursos e melhorar a qualidade de vida, para além de nos permitir interagir de formas que os nossos avós nem poderiam sonhar. Mas o que é que isto tudo tem que ver com o Informix, poderá perguntar? Não sejamos inocentes. Todo este burburinho traduz-se em oportunidades de negócio. E a IBM e os seus parceiros estão bem cientes disto. Todo este aumento de dados e  necessidades de processamento requerem sistemas de TI de qualidade e bem pensados.  Algumas áreas relevantes são:
  • Utilização em "nuvem"
  • Sistemas embebidos
  • Capacidades geo-espaciais
  • Dados "timeseries"
Soa-lhe familiar?O Informix é muito forte (para não dizer único) em todos estes aspetos. E se verificar as melhorias recentes verá que estes têm feito parte do foco da I&D do Informix
Vejamos caso a caso:
  1. Utilização em "nuvem"
    O Informix fornece alguns dos serviços de base de dados do IBM Bluemix. As suas capacidades únicas de auto-gestão, baixa manutenção, as novas funcionalidades de multi-tenancy" e muitas outras "pequenas" melhorias que podemos encontrar em fixpacksi recentes
  2. Sistemas embebidos
    Reparei recentemente que podemos aceder agora à versão para  ARM (se não sabe o que é o Arm, saiba que deve ter vários destes processadores à sua volta no smartphone, no tablet etc.) que foi anunciada à alguns fixpacks atrás. Somos a primeira base de dados comercial que corre em ARM (o DB2, Oracle, SQL Server, Sybase etc. não correm). E se isto não fosse suficiente, estamos a trabalhar na versão para Intel Quark como pode verificar num artigo recente num blog da Intel e num vídeo da sua conferência de desenvolvedores (cerca do minuto 37). Porque é que estas versões são importantes? Porque permitem que os programadores de sistemas embebidos utilizem uam base de dados comercial com todas as funcionalidades esperadas mais algumas especiais como o TimeSeries e Spatial em sistemas realmente pequenos e de baixo consumo, como as placas  Intel Galileo, Cubieboard 2+ e muitas outras (dê uma espreitadela ao Shaspa gateway device)
  3. Funcionalidades geo-espaciais
    Espero que saiba que o Informix incluí um módulo Spatial DataBlade gratuito que permite o armazenamento e processamento de informação geográfica. Na versão 12.10.xC3 melhorámos-lo permitindo cálculos habitualmente designados por Great Circle, e transformações de coordenadas entre diferentes DATA (ou mapas). Noutras palavras isto significa que podemos operar em coordenadas angulares (e não apenas coordenadas projetadas) o que permite cálculos sobre o modelo de terra redonda (e não apenas plana). Anteriormente apenas suportávamos os cálculos em 2D (permitindo no entanto armazenar os dados 3D)
  4. Funcionalidades TimeSeries
    Outro datablade suportado pelo Informix e fornecido gratuitamente, permite o armazenamento e tratamento mais eficiente de dados timeseries. E muitos dos dados relacionados com o conceito de IoT são dados deste tipo. Medidas regulares de contadores inteligentes ou sensores. Envio regular de coordenadas para fazer o seguimento de veículos etc. Uma empresa que tem chamado a atenção de analistas e desenvolvedores é a TempoDB, empresa por detrás da base de dados com o mesmo nome. Esta base de dados "apenas" fornece serviços timeseries na "nuvem"... Algo que podemos fazer com o Informix, em conjunto com a utilização de todas as outras funcionalidades SQL habituais em qualquer RDBMS estabelecido no mercado. E mais uma fez nos fixpacks mais recentes temos introduzido funcionalidades "discretas" que vão ao encontro destas necessidades
Portanto, se se interessa por estes temas, mantenha-se atento às várias redes sociais pois tem havido um fluxo crescente de informação relacionada com estes temas. E lembre-se que a sua base de dados favorita está bem no meio desta revolução.

Tuesday, March 18, 2014

Informix 12.10.xC3

This article is written in English and Portuguese (original version here)
Este artigo está escrito em Inglês e Português (versão original aqui)

English version:

IBM has just released Informix 12.10.xC3 this last Friday (March 14). The packages were available on FixCentral since the beginning of the week, but the documentation was updated only on Friday. As usual for a few years each fixpack contains small improvements and a few gems. This one is no exception. Here is the list directly from the documentation with a few comments added:

  • Migration
    • Server changes
    • JSON compatibility pre- and post-migration requirements
    • New reversion requirements
      These are "just" some new parameters and things we should consider when upgrading or downgrading. I will refer to some of them later
  • Installation
    • Server configuration
      • Automatically configure the server during installation
        If we choose to configure a server during installation, resources are adjusted automatically and the JSON listener is started
  • Administration
    • Autonomics
      • Automatic resource tuning for performance
        Some of the new parameters mentioned above are relevant to this. As an example we can have a dynamic buffer pool, let the server create more logical logs, let it adjust the physical log size and reconfigure the CPU and AIO VPs. This is another great step in the autonomic chapter.
      • Automatic location and fragmentation
        Another major change. If you prefer (set AUTOLOCATE parameter) the new tables are automatically created in a set of dbspaces, and fragmented in round-robin. If the tables grow, new fragments are automatically created. No more "no more pages" errors. For the old timer DBA (like me) this sounds tricky... but times do change and we must keep up. You're not forced to use this, but it will probably fit some environments
  • Performance
    • Control the size of private memory caches
      In previous fixpacks the private memory caches used by each CPU VP changed to dynamic. Now you have the option to make them static
    • Virtual shared memory segment size doubling
      Like we do in the extents for the tables, each 16 memory segments that we allocate we double their size. The idea is to keep their number low. But again, for old timers, 16 is already a very large number. We usually try to keep them below 5 (?). But this also means we can have them lower initially because we know that if the server grows to much, it will adapt.
  • Connectivity
    • Retrying connections
      As we've seen in 11.70.xC8, we can now define INFORMIXCONTIME and INFORMIXCONRETRY as $ONCONFIG parameters and by using the SET ENVIRONMENT statement.
      This seems nice but to be honest I was not really getting it (I should have noticed it when I wrote about 11.70.xC8). My confusion is caused by the fact that I usually use these settings to avoid spending too much time trying to connect to a dead or unreachable server. But if we cannot reach the server how would having these settings on the server side help?!
      Because this is to be applied on distributed queries and for that it makes sense.
  • Application development
    • JSON compatibility
      • Use the MongoDB API to access relational data
        You can access relational tables with the MongoDB API methods
      • Improved JSON compatibility
        New MongoDB API methods are supported like findAndModify() and some authentication related operations
    • Foreign-key constraints
      • Temporarily prevent constraint validation
        As in 11.70.xC8 this introduces the ability to use NOVALIDATE on foreign-key constraints creation to speed up the process
      • Faster creation of foreign-key constraints
        As in 11.70.xC8, real creation of foreign keys can take better advantage of existing indexes
  • Compatibility
    • Find the quarter of the calendar year for dates
      Implementation of the QUARTER() SQL function. A request from the market for better integration with 3rd party BI tools
  • High-availability clusters and Enterprise Replication
    • Connection Manager
      • Improvements to Connection Manager
        Introduction of two new redirection policies: ROUNDROBIN and SECAPPLYBACKLOG
    • Monitoring
      • View log-staging information on RS secondary servers
        Get information about log staging information in RSS servers where the DELAY APPLY functionality is in use
    • Configuration
      • Easier configuration and cloning of a server for replication
        Easily configure and start Enterprise Replication
    • Sharding
      • Shard data across Enterprise Replication servers
        Shard is a term that refers to the distribution of a single object across a number of nodes. The purpose is a bit like "divide and conqueror". By distributing records, documents or rows we make them more manageable in each node and gain performance by having more hardware dealing with our data. Informix can now "shard" relational tables and collections (JSON) across instances in an Enterprise Replication domain
  • Spatial data
    • Enhancements for handling spatial data
      More spatial reference systems and the ability to calculate area and distance for data based on the round-Earth model.
      Informix spatial data types now conform to the OpenGIS Simple Features Specification for SQL Revision 1.1 and the ISO/IEC 13249-3 SQL/MM Part 3: Spatial. The Informix spatial solution is based on the ESRI SDE 10.2 Shape and PE libraries.
  • Time series data
    • Storage
      • Efficient storage for hertz and numeric time series data
        Timeseries can store a series of sub-second values in a packed element (up to 4KB)
    • Containers
      • Control the destroy behavior for rolling window containers
        Limit the number of windows of a rolling window container that can be destroyed in a single operation
      • Monitor groups of containers with wildcard characters
        Several monitorization functions now allow wildcards in the container name
  • Faster queries
    • Faster queries by running time series routines in parallel
      Functions that can be used in WHERE clause of a SELECT statement now can take advantage of PDQ PRIORITY (parallelism) if the tables are fragmented
    • Faster queries with IN conditions through virtual tables
      Optimization for queries with IN conditions
  • Warehousing
    • Additional types of data
      • Accelerate warehouse queries in-memory using data from multiple sources
        Synonyms and views can  now reference tables in different databases, tables in databases of the same Informix instance, or tables in a different Informix instance. This work for JSON data also

Beyond the very light review above, I'd like to highlight a few points:
  1. Dynamic buffer pool. Although currently it can "only" be set to self tune (it will grow within specified limits if the read cache hits are lower than a threshold we define), this will be an historical step. I remember that while explaining the dynamic parameters we were introducing, I sometimes mentioned that "some like BUFFERPOOL will possibly never be dynamic".... Well, I must rethink that statement. Although currently it's not dynamic, if it can automatically adjust the buffers, I imagine we'll be able to do the same in the future (by using onmode -wm/wf for example)
  2. You may noticed that some features introduced in xC3 of version 12.10 were already introduced in xC8 of version 11.70. This happens because some features are being developed across more than one code line, and they appear first in version N-1 or N depending on the release schedule and calendar. Nothing to do with marketing... If the code change is feasible in more than one version we give it to customers. We don't force them to upgrade to get any new stuff. How many vendors incorporate new features in previous product versions?!
  3.  Continuous improvements in many distinctive areas: Timeseries, JSON, IWA.


Versão Portuguesa:

A IBM acabou de lançar o fixpack 12.10.xC3 esta última sexta-feira (14 de Março). Os pacotes estavam disponíveis no FixCentral desde o inicio da semana, mas a documentação só foi atualizada na sexta-feira. Como é habitual desde há uns anos, cada fixpack contém algumas pequenas melhorias e algumas pérolas. Este não é exceção. Aqui está a lista diretamente da documentação com alguns comentários adicionados:
  • Migração
    • Mudanças no servidor
    • Compatibilidade com JSON: requisitos pré e pós-migração
    • Novos requisitos para regressões
      Existem alguns novos parâmetros e algumas ações a ter em conta quando se efetua um upgrade ou downgrade de versão. Irei mencionar alguns mais tarde
  • Instalação
    • Configuração do servidor
      • Configuração automática do servidor durante a instalação
        Se escolhermos configurar um servidor durante a instalação, os recursos são ajustados automaticamente e o serviço de JSON é iniciado
  • Administração
    • Autonomics
      • Ajuste de recursos automático para melhorar o desempenho
        Alguns dos parâmetros mencionados acima são relevantes para isto. Como exemplo podemos ter uma área de buffers dinâmica, deixar o servidor criar mais logical logs, alterar o physical log e reconfigurar os VPs do tipo CPU e AIO. È mais um passo significativo no capítulo da auto-gestão dos servidores
      • Fragmentação e alocação automática
        Mais uma mudança significativa. Se preferirmos (definindo o parâmetro AUTOLOCATE) as novas tabelas são espalhadas automaticamente por um conjunto de dbspaces e fragmentadas por round-robin. Se as tabelas crescerem, novos fragmentos serão automaticamente criados. Acabam-se os erros "no more pages". Para os DBAs "antigos" (como eu) isto parece suspeito... Mas os tempos mudam e temos de os acompanhar. Não somos obrigados a usar isto, mas sem dúvida que se ajusta a alguns ambientes.
  • Desempenho
    • Controlo sobre o tamanho das caches privadas
      Em fixpacks anteriores a memória privada alocada às caches de cada CPU VP passou a ser dinâmica. Agora existe a possibilidade de escolha e podemos defini-las com um tamanho estático também
    • Duplicação do tamanho dos segmentos virtuais
      Tal como fazemos nos extents das tabelas, a cada 16 segmentos que alocarmos o seu tamanho duplica. A ideia é manter o seu número "baixo". Mas mais uma vez, para os "antigos", 16 já é um valor demasiado alto. Normalmente tentamos manter o seu número abaixo de 5 (?). Mas apesar disso, isto significa que talvez possamos definir o seu tamanho muito mais pequeno ao início, pois sabemos que se o servidor crescer muito irá adaptar-se
  • Conectividade
    • Definição de tentativas de conexão
      Como vimos na 11.70.xC8, podemos agora definir as variáveis INFORMIXCONTIME e INFORMIXCONRETRY como parâmetros no $ONCONFIG e pela utilização da instrução SET ENVIRONMENT.
      Isto parece muito bem, mas para ser honesto, receio que não estava a compreender totalmente esta funcionalidade (e devia ter notado isto quando escrevi sobre a 11.70.xC8). A minha confusão foi causada pelo fato de que habitualmente uso estes parâmetros ou variáveis para evitar perder muito tempo a tentar ligações a um servidor que está em baixo ou não está acessível. Mas nesses casos, como é que ter estes parâmetros do lado do servidor ou numa sessão já estabelecida ajudariam?! Na verdade a ideia é aplicar isto a queries distribuídas e aí já faz todo o sentido
  • Desenvolvimento aplicacional
    • Compatibilidade com JSON
      • Usar a MongoDB API para aceder a dados relacionais
        Podemos aceder a tabelas relacionais (tradicionais) do Informix com os métodos da MongoDB API
      • Mais compatibilidade com  JSON
        Mais métodos da MongoDB API são agora suportados como o findAndModify() e alguns outros relacionados com autenticação
    • Chaves estrangeiras
      • Desabilitar temporariamente a validação das chaves estrangeiras
        Como na 11.70.xC8, isto introduz a possibilidade de usar a cláusula NOVALIDATE na criação de chaves estrangeiras
      • Criação mais rápida de chaves estrangeiras
        Tal como na 11.70.xC8, a criação de chaves estrangeiras (com validação) pode tirar mais proveito de índices já existentes
  • Compatibilidade
    • Obter o trimestre (quarter) de uma data
      Implementação da função SQL QUARTER(). Um pedido do mercado para integração com terceiros, fornecedores de ferramentas de BI
  • Clusters de alta-disponibilidade e Enterprise Replication
    • Connection Manager
      • Melhorias no Connection Manager
        Introdução de duas novas políticas de redirecionamento: ROUNDROBIN e SECAPPLUBACKLOG
    • Monitorização
      • Obter informação sobre log staging em servidores secundários remotos
        Em servidores onde o DELAY APPLY foi ativado é possível agora obter informação sobre os logs que vão sendo acumulados
    • Configuração
      • Facilidade na configuração de um servidor para Enterprise Replication
        A ferramenta de clonagem (ifxclone) facilita agora a ativação automática de Enterprise Replication
    • Sharding
      • Shard de dados entre servidores configurados em Enterprise Replication
        "Shard" é um termo que se refere à distribuição de um objeto pelos nós de um cluster de replicação. O objetivo é um pouco "dividir para reinar". Ao distribuir registos, documentos ou linhas torna-mo-los mais manejáveis em cada nó e ganhamos desempenho pois temos mais hardware para os gerir. O Informix pode agora fazer o shard de tabelas relacionais e collections JSON entre instâncias configuradas num domínio de Enterprise Replication
  • Dados espaciais
    • Melhorias no tratamento de dados espaciais
      Mais sistemas de referência e a possibilidade de calcular áreas e distâncias em dados baseados no modelo esférico da Terra.
      Os tipos de dados espaciais seguem agora a norma OpenGIS Simple Features Specification for SQL Revision 1.1 e a ISO/IEC 13249-3 SQL/MM Part 3: Spatial. A solução espacial Informix é baseada nas bibliotecas ESRI SDE 10.2 Shape e PE
  • Dados Timeseries
    • Armazenamento
      • Armazenamento eficiente para dados em séries numéricas e hertzianos
        Um elemento Timeseries compactado pode conter até 4KB de dados hertzianos (intervalos sub-segundo)
    • Containers
      • Controlo sobre o comportamento destrutivo de rolling window containersPodemos limitar o número de janelas que são destruídas numa só operação sobre um container em rolling window 
      • Monitorizar containers com caracteres wildcard
        Várias funções de monitorização passam a aceitar wildcards nos nomes dos Containers
  • Queries mais rápidas
    • Queries mais rápidas via execução paralela de rotinas
      As funções que podem ser usadas na cláusula WHERE das instruções SELECT podem ser executadas em paralelo (tirando proveito dos valores de PDQPRIORITY) se as tabelas estiverem fragmentadas
    • Queries mais rápidas nas condições IN sobre tabelas virtuais (VTI)
      Otimização de queries com IN
  • Warehousing
    • Tipos de dados adicionais
      • Aceleração de warehouse queries in-memory usando dados de múltiplas fontes
        Sinónimos e views usados para o IWA podem agora referencias tabelas em diferentes bases de dados, tabelas da mesma instância ou tabelas noutras instâncias. Dados JSON podem também ser usados

Para além da breve análise acima, gostaria de salientar alguns pontos:
  1. Buffer pool dinâmica. Apesar de atualmente "apenas" poder ser configurada para se auto-ajustar (crescerá se a percentagem de hits da cache de leitura ficar abaixo do limite por nós definido durante um intervalo de tempo), este será um passo histórico.
    Recordo-me de em várias ocasiões estar a explicar a transformação gradual dos parâmetros em dinâmicos (poderem ser mudados sem parar a instância), ter referido que "a BUFFERPOOL por exemplo possivelmente nunca será dinâmico". Parece que tenho de rever esta posição, ainda que de momento e no sentido estrito não o seja. Mas parece-me razoável pensar que no futuro poderemos mudar este parâmetro com um onmode -wm/-wf ou usando a SQL Admin API
  2. Poderá ter reparado que algumas das funcionalidades aqui descritas já tinham aparecido na 11.70.xC8. Isto acontece porque algumas mudanças de código podem ser transversais às versões, aparecendo na N-1 ou N conforme o ciclo normal de releases e o calendário. Nada que ver com marketing. Se a mudança de código é viável na versão N-1 nós fornece-mo-la aos clientes. Não obrigados a estar sempre na última versão se quiser beneficiar de algumas inovações. Quantos fornecedores incorporam funcionalidades novas em versões anteriores dos seus produtos?
  3. Melhorias contínuas em áreas que distinguem o Informix da concorrência: Timeseries, JSON e IWA.

Friday, March 29, 2013

Informix 12.10 is ready / Informix 12.10 está pronto

This article is written in English and Portuguese
Este artigo está escrito em Inglês e Português


English version:
As we should all know by now, IBM announced the next major Informix version last Tuesday, March 26 with a webcast that is available for replay here.
I must confess I was a bit surprised with the webcast format. Being an IBMer, I was in touch with this new release and I knew most (if not all) the new features. And I was expecting a mostly technical session going through all the bits and bytes. Instead of that we got something that we're not used to in "informix land": A strategic positioning of the product and current direction with the focus on the main differentiation points. More importantly we got a partner going through their real world experience with the beta versions of the product, and some simple but effective graphics of the performance achievements.

I believe that from my own internal knowledge and from the webcast I can say that the main focus points of this release are (and I'm not going technical here/yet) with no particular order:

  • TimeSeries data
    No other database has incorporated so much technology and effort for this. And while the classical usage examples are the smart meters, I believe we're still missing the point because there are so many "time series" sources out there (weather data, demographic data, smart cities data including traffic, people movement, noise data, air quality data etc..)
  • Warehouse enhancements
    The Informix Warehouse Accelerator is really a unique product. Mix OLTP and BI use in the same system. Use in-memory technology. Allow for "self service" BI. Unprecedented low maintenance and ease of use. And this release brings the so called OLAP functions, or windowed aggregates, things like RANK(), LEAP(), ROWNUM() etc. These were lacking in Informix so it's the elimination of a gap
  • Grid enhancements
    Again, I believe no other RDBMS has this capability as Informix provides. And the new grid queries open up a whole new world
  • Usability
    The improvements in OAT. The SQL compatibility enhancements. More dynamic parameters. A datablade with many competitor functions for compatibility. The removal of some limitations in non-root installations and much more
  • Changes in editions and bundling
    This point will always raise some discussion. In terms of names we went back to the workgroup and enterprise names, while there are other bundlesspecially for data warehouse environments which include some licenses for Cognos and SPSS. These ones have advanced in their names. Naturally there are technical and legal restrictions on their usage, so choosing between the several editions requires a careful analysis of their licensing terms
There is also another perspective to look at this release.... There are a few things that are a bit harder to understand about some of the new features... Things like temp structures column elimination, faster ANSI joins and others that are not even mentioned (just check out the new sysmaster.sql) reflect a lot of hard work in the background that it's not easily translated into "features".

I was also surprised with the release process. Unfortunately we're used to see the software on Passport Advantage or FixCentral, then wait for the InfoCenter, than the PDF manuals.... And all these take a few days until it eventually is all available. This time I was able to download the software before the webcast. The InfoCenter was up and running, and the PDFs containing the manuals were available individually, and the whole PDF pack took one or two days. Again this was a very good surprise. I just hope we can keep it for the upcoming fixpacks.

As for the technical bits and bytes, I will try to catch up on the post rates while I cover some of the new features. For now, if you're interested (and you should be), please check the "What's new" link in InfoCenter


Versão Portuguesa:

Como todos já devemos saber, a IBM anunciou a próxima versão do Informix na passada terça-feira, 26 de Março, num webcast que está disponível para rever aqui.
Tenho de confessar que fiquei um pouco surpreendido com o formato da apresentação. Sendo um IBMer, tinha já algum contacto com esta nova versão e conhecia a maioria (senão todas) das novas funcionalidades. E estava a aguardar uma sessão essencialmente técnica que explicasse todos os bits e bytes. Em vez disso observámos algo a que não estamos muito habituadas no "mundo informix": Um posicionamento estratégico do produto, com a visão e direção atual, e o foco nos principais pontos diferenciadores. Ainda mais importante, tivemos a presença de um parceiro que descreveu a sua experiência com situações reais usando as versões beta do produto, e alguns gráficos simples mas eficientes que demonstraram significativos ganhos de performance com esta versão.

Penso que juntando as mensagens internas e este webcast, se pode dizer que os principais pontos desta nova versão são (não vou abordar aspetos técnicos aqui/ainda), sem nenhuma ordem especial:
  • Dados TimeSeries
    Nenhuma outra base de dados incorporou tanta tecnologia e esforço para isto. E se por enquanto o exemplo clássico são os contadores inteligentes (smart meters) penso que ainda estamos a falhar oportunidades, porque existem tantas fontes de dados timeseries por aí (dados de clima, dados demográficos, dados de smart cities incluindo medições de tráfego, movimentos de pessoas, medidas de ruído, qualidade do ar etc...)
  • Melhorias para Warehouse
    O Informix Warehouse Accelerator é realmente um produto único. Misturar utilização OLTP e BI no mesmo ambiente. Uso de tecnologia in-memory. Baixa manutenção e facilidade de uso sem precedentes. Permitir BI self service. E esta versão traz as funções OLAP windowed aggregates, coisas como o RANK(), LEAP(), ROWNUM() etc. Estas faziam falta ao Informix há bastante tempo, pelo que se trata da eliminação de uma falta
  • Melhoramentos em Grid
    Novamente, julgo que nenhuma outra base de dados relacional tem a capacidade demonstrada pelo Informix. E as novas grid queries abrem todo um novo mundo
  • Facilidade de utilização
    As novas funcionalidades no OAT. A melhoria de compatibilidade de SQL. Mais parâmetros dinâmicos. Um datablade com várias funções compatíveis com a concorrência. A remoção de algumas limitações em instalações sem recurso a root
  • Alteração nas edições
    Este aspeto será sempre polémico. Em termos de nomenclatura voltou-se ao workgroup e enterprise, havendo outras edições pensadas para data warehouse que incluem licenças para alguns utilizadores de Cognos e SPSS. Estas designam-se por advanced. Naturalmente algumas edições têm limitações legais e/ou técnicas ao seu uso, e a escolha de uma em vez de outra requer uma análise cuidada aos termos de licenciamento
Existe ainda outra perspetiva sobre esta nova versão.... Há algumas coisas que não são fáceis de compreender relativamente às novas funcionalidades.... Coisas como a eliminação de colunas em estruturas temporárias (como tabelas derivadas), joins ANSI mais rápidos, e outras que nem são mencionadas (verifique por exemplo o novo sysmaster.sql) refletem um significativo trabalho  de bastidores que nem sempre é fácil traduzir em novas funcionalidades

Fiquei também surpreendido com o processo de publicação e disponibilização de ficheiros e manuais. Infelizmente estamos habituados a ver o software no site Passport Advantage ou FixCentral, depois esperar pela atualização do InfoCenter, depois os manuais em formato PDF... E tudo isto demora alguns dias até estar realmente disponível. Desta vez consegui transferir o software, antes do inicio do webcast. O InfoCenter estava disponível e os PDFs dos manuais estavam disponíveis individualmente. O pacote completo de manuais demorou um ou dois dias a aparecer. Esta foi outra das boas surpresas deste lançamento. Espero que consigamos manter este procedimento para os futuros fixpaks

Quanto aos detalhes técnicos tentarei retomar um bom ritmo de artigos enquanto tento abordar algumas das novas funcionalidades. Por agora, se estiver interessado (e deverá estar) verifique o link "What's new" no InfoCenter

Saturday, May 26, 2012

Informix 11.70.xC5: It's available / Já está disponível

This article is written in English and Portuguese
Este artigo está disponível em Inglês e  Portguês


English version:
The new fixpack of Informix 11.70 (xC5) is available and the Infocenter documentation was just updated as well as the PDF sets of manuals.
Taken directly from the release notes the new features and functionalities are (comments added after the bullet items):

  • Administration
    • Plan responses to medium-severity and low-severity event alarms
      Mainly a documentation improvement. By describing each possible event ID and the recommended action, IBM is continuing the improvement of the alarm handler allowing the end user to costumize the ALARMPROGRAM scripts
    • IFX_BATCHEDREAD_INDEX environment option
      The batched index read feature can now be controled using SQL through the SET ENVIRONMENT statement
  • Application development
    • Improvement to the keyword analyzer for basic text searching
      An improvement on the way the Basic Text Seach datablade (BTS) handles the keyword analysis to create it's indexes
    • Increased SQL statement length
      It may look a small feature if you never hit the 64KB limit, but it can be a must have if you ever faced that limit. Currently the limit was increased to an absurd 4GB with the exception of the CREATE VIEW which is 2MB
    • Enhanced query performance
      This can be misleading. What it is in fact is that the size of the client/server communication buffer can now be changed to 2GB by using the FET_BUF_SIZE variable. The driver for this was a competitive situation where it was identified that this could be a bottleneck. Note that this can be important for UNLOADs, exports etc.
    • The Change Data Capture API sample program
      Not really a feature. One program that was only found on the docs is now available in $INFORMIXDIR/demo/cdc for convenience
  • Enterprise replication
    • Replication errors on leaf nodes
      Since the leaf nodes in an ER topology can't have much information about errors on other servers, that errors are removed from the syscdrerror tables on leaf nodes
  • Global language support
    • Scan strings with the ifx_gl_complen() functions
      Performance improvement for GLS code
  • Time Series data
    • Count the time-series elements that match expression criteria
      COUNTIF function
    • Remove old time-series data from containers
      Allows the re-use of space after old data removal
    • New operators for aggregating across time-series values
      Improvement to the TSRollup function
  • Data warehousing
    • Refresh data quickly without reloading the whole data mart
      A single partition (fragment) of a fragmented table can be sent to the IWA in-memory database
    • Use high-availability secondary servers to accelerate queries
      HDR, RSS and SDS servers can now be used to create and load datamarts. Previously they could only be used to accelerate queries. This is a big improvement if you want to mix OLTP and BI workloads since you could offload a large part of the BI to the secondary node(s) leaving the primary to the main OLTP work
    • New options added for the use_dwa environment variable
      Several new options for this variable allow you to gain more control about how a session uses the Informix Warehouse Accelerator and to collect more data to understand it's behavior
    • Support for new functions is implemented
      Several new functions are supported in the accelerator, which allows more queries to benefit from it. This time the functions added were: LEN, LENGTH, SUBSTR, SUBSTRING, TODAY, TRIM and YEAR
    • Support for the Solaris Intel x64 operating system added
      This increases the number of platforms where the connection to Informix Warehouse Accelerator is supported. Currently they are: AIX, HP-UX, Solaris Sparc, Solaris Intel and Linux. I'd say the only one missing that matters is Windows!
To be honest, at first glance I didn't find this fixpack had the number of new features that we've become used to in the latest ones. My fellow colleague from tech support immediately found this good (sometimes new features bring new issues and tech support likes "quiet" releases that allow easy rollback to previous versions). But on the other hand if we look into some of these features, we really see that our R&D has been busy. I'm thinking about the Warehouse Accelerator features, the Timeseries and in particular the size of the SQL statements. I believe some people have been struggling with this for many years. And the increase of the maximum client/server communication buffer, can have a dramatic effect on some specific situations. But this is not all. This release has a lot of work that unfortunately is not documented yet. This is divided into two areas:
  1. Performance improvements that can cause issues on some customers or that break undocumented behaviors that applications rely upon. These features have hidden variables that can change the engine behavior if customers hit any issues. Personally I don't like this kind of things, but after seeing some explanations about some of these I tend to understand why this approach was adopted. I have sporadically faced some of these situations over the years and I noticed that one behavior may be desirable in some cases and not in others
  2. New functionality that may be provided to some selected customers or partners while still being developed and improved. This will surely be part of the next major release and the benefit is that they'll be much more stable when they're officially released
So, in short, another fixpack, some significant improvements in Warehouse Accelerator, Timeseries and other very specific points, and a lot of "undercover" work that follows a well established roadmap. Of course I could be accused of "whispering" simply to promote the work of R&D, but if you follow my posts you must agree I don't usually do this. Some stuff that I'm thinking about have recently come up on IIUG mailing list discussion, following up on some other blog's post, so I'm not even the first one to "leak" some of this. Hopefully in the future I'll be able to post something like "do you remember when I whispered about some undercover work? That was this and this and that..." and then you can pick up the "old" 11.70.xC5 fixpack and try a couple of tricks :)

Versão Portuguesa:

O novo fixpack do Informix 11.70 (xC5) está disponível e a documentação no Infocenter e nos PDFs foi actualizada
Tirado diretamente das release notes as novas funcionalidades são (comentários adicionados após cada ponto):

  • Administração
    • Planeamento de respostas para alarmes de baixa e média severidade
      Essencialmente é uma melhoria na documentação. Ao descrever cada possível evento (ID) e as ações recomendadas, a IBM continua a melhorar o gestor de alarmes permitindo ao utilizador final costumizar o seu script para o ALARMPROGRAM
    • Opção de ambiente IFX_BATCHEDREAD_INDEX
      A funcionalidade batched read index pode agora ser controlada por SQL através da instrução SET ENVIRONMENT
  • Desenvolvimento aplicacional
    • Melhoria na análise de palavras chave para a pesquisa básica de texto
      Uma melhoria na forma como o Basic Text Search (BTS) datablade lida com a análise de palavras-chave para criação dos seus índices
    • Aumento do tamanho das instruções SQL
      Pode parecer uma pequena melhoria, se nunca atingiu o limite de 64KB, mas pode ser crítico se alguma vez se deparou com este limite. Desta feita o limite foi aumentado para uns absurdos 4GB, com exceção de um CREATE VIEW que está limitado a 2MB 
    • Performance de queries melhorada
      Esta descrição pode ser enganadora. Não se trata de uma alteração ao optimizador, mas sim da capacidade de aumentar o buffer de comunicação entre o servidor e o cliente para 2GB. Isto pode ser controlado com a variável de ambiente FET_BUF_SIZE que até aqui só podia ir até 32KB. A razão para esta alteração foi uma situação de competição com outra base de dados onde isto foi identificado como um factor limitativo da performance. Note-se que isto pode ser importante para UNLOADs, dbexports etc.
    • Programa de exemplo de Change Data Capture API
      Não é propriamente uma funcionalidade. Um programa que apenas podia ser encontrado no manual pode agora ser mais facilmente utilizado pois existe em $INFORMIXDIR/demo/cdc
  • Enterprise replication
    • Erros de replicação nos leaf node
      Dado que os nós "folha" numa topologia ER não podem ter muita informação sobre erros de outros servidores (acima na cadeia), esses erros foram removidos da syscdrerror nos servidores "folha"
  • Suporte global language
    • Varrer strings com as funções  the ifx_gl_complen()
      Melhoria de performance no código GLS
  • Dados Timeseries
    • Contar os elementos time-series que verificam uma expressão de critério
      Função COUNTIF
    • Remoção de dados antigos de containers de time-series
      Permite a re-utilização de espaço após a eliminação de dados antigos
    • Novos operadores para agregação de valores time-series
      Melhoria na função TSRollup
  • Data warehousing
    • Refrescamento rápido de dados sem re-carregar todo o data mart
      Podemos refrescar apenas uma partição (fragmento) de uma tabela na base de dados in-memory do IWA
    • Utilizar os servidores secundários para acelerar as queries
      Os servidores HDR, RSS e SDS podem ser usados para criar e carregar data marts. Anteriormente apenas podiam ser usados para acelerar queries. Isto é uma grande melhoria se quer misturar utilizações OLTP e BI dado que se pode direcionar toda a carga de BI para os nós secundários, deixando o primário liberto para o trabalho OLTP
    • Novas opções adicionadas à variável use_dwa
      Várias opções foram adicionadas a esta variável para providenciar maior controlo sobre como uma sessão utiliza o Informix Warehouse Accelerator e para recolher mais dados para entender o seu comportamento
    • Suporte para novas funções
      Várias novas funções são suportadas pelo acelerador, o que permitirá que ainda mais queries sejam aceleradas. Desta feita as funções adicionadas foram: LEN, LENGTH, SUBSTR, SUBSTRING, TODAY, TRIM e YEAR
    • Suporte para o sistema operativo Solaris Intel x64
      Aumentou a lista de plataformas que suportam a conexão ao Informix Warehouse Accelerator. Atualmente são: AIX, HP-UX, Solaris Sparc, Solaris Intel e Linux. Diria que a única ausência relevante será o Windows!
Para ser  honesto, à primeira vista, não me pareceu que este fixpack tivesse o mesmo número de funcionalidades a que nos temos habituado nos últimos. O meu colega do suporte técnico considerou imediatamente que isto era positivo (por vezes funcionalidades novas trazem novos problemas e o suporte gosta de versões "calmas", e que permitam regressão com paragem e arranque simples). Mas por outro lado, se olharmos para algumas das novas funcionalidades, verificamos que realmente o desenvolvimento tem estado bastante ocupado.

Estou a pensar em particular nas funcionalidades do Informix Warehouse Accelerator, nas de TimeSeries e muito especificamente no alargamento do limite dos comandos SQL. Sei que alguns clientes têm sofrido com este limite há anos. E o aumento do tamanho máximo do buffer de comunicação pode ter um efeito dramático em situações específicas. Mas isto não é tudo. Esta versão incorpora muito trabalho que infelizmente não está documentado (ainda). Isto divide-se em duas grandes áreas:

  1. Melhorias de performance que podem causar problemas em alguns clientes ou que alteram comportamentos não documentados dos quais algumas aplicações podem depender. Estas funcionalidades tem associadas variáveis não documentadas que podem mudar o comportamento do motor caso os clientes encontrem algum problema. Pessoalmente não gosto deste tipo de configurações, mas após ter visto algumas explicações sobre algumas destas funcionalidades acabo por compreender o porquê de se ter seguido esta abordagem. Já encontrei algumas destas situações esporadicamente e verifiquei que um comportamento pode ser bom para uns casos e mau para outros
  2. Novas funcionalidades que podem ser disponibilizados a clientes e/ou parceiros selecionados enquanto ainda estão a ser desenvolvidas ou melhoradas. Estas serão certamente disponibilizadas numa próxima versão, sendo que o benefício desta abordagem é que quando for feita a introdução formal, estarão muito mais estáveis
Em resumo, mais um fixpack, algumas melhorias significativas no Informix Warehouse Accelerator,  Timeseries e outros pontos muito específicos, e muito trabalho de bastidores que segue um roadmap bem estabelecido. Claro que posso ser acusado de criar "boatos" simplesmente para promover o trabalho do desenvolvimento, mas se segue os meus artigos deverá concordar que tal não é o meu hábito. Algumas das coisas em que estou a pensar quando refiro o trabalho de bastidores foram referidas na lista de email do IIUG recentemente, no seguimento de um artigo de outro blog, portanto nem sequer sou o primeiro  a deixar passar alguma informação mais restrita. Seguramente no futuro ser-me-á possível escrever algo do tipo "lembram-se quando mencionei algum trabalho de bastidores? Referia-me a isto, isto e isto..." e depois poderá pegar na "velha" versão 11.70.xC5 e testar alguns truques :)

Thursday, February 09, 2012

Sweet CRM / Doce CRM

This article is written in English and Portuguese
Este artigo está escrito em Inglês e Português

English Version:

A recent press release by Oninit is being echoed across the Internet. Oninit have completed the port of SugarCRM, an open-source CRM system to Informix.
This gives SugarCRM users the opportunity to use Informix as the underlying database to their CRM system, effectively taking advantage of all the features we all know and love (performance, scalability, high availability features, complete platform options, simplicity etc.).

But there is even more to this.. Accordingly to SugarCRM site there were already a number of points connnecting SugarCRM and IBM (Cognos and SugarCRM working together, Lotus integration, IBM systems etc.).
It's also important to note that from a cost reduction point of view, the free Informix versions or the ones with lower costs can be an excellent companion for SugarCRM.
You can start small... Informix will grow as your business.

This is another great news about integration of Informix with many products (MediaWiki, XWiki, iBatis, Hibernate, Drupal, Alfresco and others).
Congratulations to Oninit for another great job (following several TimeSeries activities)

Versão Portuguesa:

Um comunicado de imprensa recente, pela Oninit está a ter eco na Internet. A Oninit completou a adaptação para que o CRM open-source SugarCRM passe a trabalhar também com Informix.
Isto permite aos utilizadores de SugarCRM usar o Informixx como base de dados de suporte do seu sistema de CRM, aproveitando assim as funcionalidades que conhecemos e apreciamos (rapidez, capacidade de escalar, alta-disponibilidade, disponibilidade de várias plataformas, simplicidade etc.).


Mas há ainda mais sobre isto... Segundo o site do SugarCRM já existiam um número de pontos de contacto entr o SugarCRM e a IBM (ligação entre SugarCRM e Cognos, integração com Lotus. sistemas IBM etc.).
Há ainda que referir que numa óptica de poupança de custos, as versões gratuitas ou de menor custo do Informix podem ser uma excelente companhia para o SugarCRM.
Pode começar pequeno... O Informix acompanhará o crescimento do seu negócio.


Isto é mais uma excelente notícia sobre a integração de Informix com muitos outros produtos (MediaWiki, XWiki, iBatis, Hibernate, Drupal, Alfresco e outros).
Parabéns à Oninit pela excelente iniciativa (depois de várias atividades relacionadas com Informix Timeseries)

Thursday, November 03, 2011

Informix 11.70.xC4 is available / Informix 11.70.xC4 está disponível

This article is written in English and Portuguese
Este artigo está escrito em Inglês e Português

English Version:

IBM has relesed Informix 11.70.xC4 in October 25. The changes in this release, taken directly from the release notes, are (comments added):


  • Administration
    • Enhancements to the OpenAdmin Tool (OAT) for Informix
      OAT now allows the management of database users (for non-OS users) and OAT is now delivered and installable with Client SDK for Windows (32bits), Linux (32 and 64 bits) and MAC OS (64 bits)
    • Enhancements to the Informix Replication Plug-in for OAT
      The ER plugin now follows ER improvements and can handle multibyte locales.
    • Informix Health Advisor Plug-in for OAT
      A totally new plugin that can examine a great number of metrics and configuration details, warning you (email) of anything not within the recommended settings and/or defined thresholds.
      The checks can be scheduled and you can setup several different profiles. Each will run a specific (and configurable) set of metrics.
    • Dynamically change additional configuration parameters
      Several parameters can now be changed with onmode -wm/-wf. Some of them are really important (WSTATS, AUTO_REPREPARE, CKPTINTVL, DIRECTIVES, OPTCOMPIND, SHMADD) and can save you from planned downtime. Others are more or less irrelevant (some of them could be changed by editing the $ONCONFIG file), but it's important that they can be changed through SQL Admin API for client DBA tools
    • Compare date and interval values
      API extensions to compare datetime and interval values.
    • Plan responses to high severity event alarms
      Could not understand what is new. This could be done before by customizing the ALARMPROGRAM script
    • Data sampling for update statistics operations
      A new parameter (USTLOW_SAMPLE) defines if you want to sample the data for the index information gathering or not (indexes with more than 100.000 leaf pages). 11.70.xC3 did this by default. This can also be set at session level. Note that this can have a dramatic impact on the time it takes to regenerate your statistics. The "LOW" will be the slowest for large tables with indexes...
    • SQL administration API command arguments for creating sbspaces
      New options to create smart blob spaces with logging and access time recording in SQL admin API
    • Monitor client program database usage
      The client program's full path name is now available in onstat -g ses.
      Note that although you can use this to monitor and control access, this information is sent by the client side and potentially can be faked (not the average user, but an attacker could do it)
    • Progress of compression operations
      Two new columns in onstat -g dsk show the approximate percentage of the tasks already completed and the estimated time to finish
  • High availability and Enterprise Replication
    • Easier setup of faster consistency checking
      When using ifx_replcheck and an index is created on it, the CRCOLS are not necessary
    • Handle Connection Manager event alarms
      Scripts used for processing connection manager alarms now have access to two variables that identify their name (INFORMIXCMNAME) and unit name (INFORMIXCMCONUNITNAME). This facilitates the script creation
    • Easier startup of Connection Manager
      When the variable CMCONFIG is set and points to the connection manager configuration file, it can be started, stop and restarted without specifying the configuration file. Much like ONCONFIG is used for the engine
    • Prevent failover if the primary server is active
      A new parameter called SDS_LOGCHECK can specify an number of seconds while the SDS secondaries will monitor the logical logs for activity (which would be generated by the primary server). This tries to implement a safety measure to prevent an SDS server to become a primary after a "false" failure of the primary. Note that usually this is prevented by using I/O fencing, but if that is not available this can be another way to make sure you don't end up with two primaries
    • Configure secure connections for replication servers
      A new parameter called S6_USE_REMOTE_SERVER_CFG defines if the file specified by REMOTE_SERVER_CFG will also be used for client connections using the s=6 SQLHOSTS options (for replication). If this parameter is set to 1 the file will be used, otherwise it will default to the old behavior and use $INFORMIXDIR/etc/hosts.equiv
  • Security
    • Global Security Kit (GSKit) support
      A new parameter (GSKIT_VERSION) can be used to specify the Global Security Kit version you intend to use. Informix 11.70.xC4 ships with version 8, but can use version 7
    • Use a file to authenticate server connections in a secured network environment
      Already mentioned above (S6_USE_REMOTE_SERVER_CFG)
  • Time Series data
    • IBM Informix TimeSeries Plug-in for Data Studio
      This new plugin allows the interaction with TimeSeries data from Optim Data Studio and Optim Developer Studio
    • Delete a range of elements and free empty pages from a time series
      Delete improvements in TimeSeries data that should free some pages
    • Aggregate time series data across multiple rows
      Improvement in how we can aggregate TimeSeries data.
Besides bringing some new features, this release also fixes some important bugs that appeared in xC3 around the new automatic read ahead configuration. Apart from this I think it's important to notice the following points:

  • TimeSeries continues to have a great focus on the current enhancements off Informix. This is expectable and desired considering the great news around customer success stories and the recent benchmark.
  • The new OAT health plugin. I didn't have time yet to really explore it, but for sure I would have done a few things differently like re-using the alarmprogram configuration to send alarms. But this is great and being a plugin it can easily be changed if it doesn't fit your needs.
  • The inclusion of OAT inside CSDK is a good step (from my point of view). It makes it easier to get and install. I've installed it very quickly in Windows
  • The new dynamically changeable parameters are a very good step. Of course I would love to be able to change all the parameters without stopping the instance. But we're getting closer. My next favorites would be (and why):
    • LOGBUFF, PHYSBUFF
      After instance healthchecks, may times these should be changed
      I suppose this should not be to hard, since there are a set of each and they're used in a circular fashion. So on change, they could be resized.
      LOGBUFF would probably be harder due to it's role in replication (HDR)
    • TBLSPACE_STATS
      Again, it's a good practice to have this active. But having to stop the instance to fix this is not nice
    • SYSSBSPACENAME, SBSPACENAME
      Sometimes these are not set, but the usage of some new features required them. A restart is not nice...
    • CLEANERS
      Again, many times needed after a configuration check
    • SHMTOTAL
      Many customers don't set it. And sometimes you may need to reduce it or increase it (new OS are able to add/remove memory online). Of course we would not be able to lower it below current usage.
    • DD_*, DS_*, PC_*, PLCY_*, USRC_
      Again, usual candidates to change after a health check. These would be trickier to change, but if we did it for statement cache we should be able to do it for all the other caches. Also a functionality to "flush" these caches or at least remove some entries would be nice.
    • EXT_DIRECTIVES
      Some times customers find out they need it, but it's off by default... Again the restart
    • DBCREATE_PERMISSION
      This is in my view dynamic by nature


Versão Portuguesa:

A IBM lançou o Informix 11.70.xC4 no dia 25 de Outubro. Estas são as mudanças nesta versão (retiradas directamente das release notes (comentários adicionados):


  • Administração
    • Melhorias no OpenAdmin Tool (OAT)
      O OAT permite agora a gestão dos utilizadores de base de dados (para utilizadores não autenticados no sistema operativo) e é agora distribuido com o Client SDK para Windows (32bits), Linux (32 and 64 bits) e MAC OS (64 bits)
    • Melhorias no plugin de replicação do OAT
      O plugin de ER segue as emlhorias do próprio ER e pode lidar com locales multibyte
    • Informix Health Advisor Plug-in para o OAT
      Um plugin totalmente novo que pode examinar um grande número de métricas e detalhes de configuração, avisando (por email) de algo que fuja às recomendações e/ou a parâmetros pré-definidos. Podemos calendarizar verificações periódicas de acordo com vários perfis. Cada perfil irá validar um conjunto de métricas especificas (e configurável)
    • Alteração dinâmica de mais parâmetros
      Vários parâmetros podem agora ser mudados com o onmode -wm/-wf. Alguns são realmente importantes (WSTATS, AUTO_REPREPARE, CKPTINTVL, DIRECTIVES, OPTCOMPIND, SHMADD) e podem evitar paragens planeadas. Outros são relativamente irrelevantes (alguns já podiam ser alterados editando o $ONCONFIG), mas é importante que possam ser alterados através da SQL Admin API, para que possam ser mudados em ferramentas cliente
    • Comparação de datas e intervals
      Extensão da API extensions para comparar valores dos tipos datetime e interval
    • Planear resposta a eventos de alta severidade
      Não consegui perceber o que foi feito de novo. Isto já podia ser feito através da configuração/adaptação do script configurado no parâmetros ALARMPROGRAM
    • Data sampling para operações de UPDATE STATISTICS
      Um novo parâmetro (USTLOW_SAMPLE) define se queremos efectuar sampling na recolha de dados sobre os índices ou não (índices com mais de 100.000 "folhas" - leaf pages). 11.70.xC3 fazía-o por omissão. Isto pode ser activado ao nível da sessão. Note-se que isto pode ter um impacto dramático no tempo que leva a refazer as estatísticas. A opção "LOW" é a mais lenta para tabelas grandes em muitos casos..,
    • Novos argumentos para criar smart blob spaces com a SQL administration API
      As novas opções permitem criar os smart blob spaces com ou sem logging e mantendo ou não o tempo de acesso aos objectos
    • Monitorização do uso das bases de dados por programa cliente
      O nome (caminho) completo do programa cliente está disponível no output do onstat -g ses
      Note-se que apesar de isto poder ser usado para monitorizar ou até condicionar o acesso a uma base de dados, esta informação é enviada pelo cliente e pode potentcialmente ser alterada (não pelo utilizador comum, mas certamente por um atacante)
    • Consulta do progresso das operações de compressão
      Duas novas colunas no output do onstat -g dsk mostras a percentagem aproximada de trabalho já efectuado e o tempo estimado para a sua conclusão
  • Alta disponibilidade e Enterprise Replication
    • Configuração mais fácil de verificação de consistência
      Quando se usa o ifx_replcheck, e se cria um índice por ele, os CRCOLS não são necessários
    • Lidar com alarmística do Connection Manager
      Scripts usados para processar os alarmes do(s) connection managers têm agora acesso a duas variáveis que identificam o seu nome  (INFORMIXCMNAME) e nome de unidade (INFORMIXCMCONUNITNAME). Isto facilita a criação dos scripts
    • Arranque facilitado do Connection Manager
      Quando a variável CMCONFIG está definida e aponta para o ficheiro de configuração do Connection Manager, este pode ser iniciado, parado e re-iniciado sem especificar o ficheiros de configuração. Muito semelhante à utilização da variável ONCONFIG para o motor
    • Prevenção de failover se o servidor primário ainda estiver activo
      Um novo parâmetro, chamado SDS_LOGCHECK pode indicar o número de segundos que os SDS secundários irão monitorizar os logical logs para detectar actividade (que a existir seria gerada pelo primário). Isto tenta implementar uma medida de segurança para prevenir que um servidor SDS se torne primário em caso de falsa falha do primário. Note-se que habitualmente isto é prevenido com recurso ao I/O fencing, mas se essa funcionalidade não estiver disponível, esta pode ser outra forma de evitar ficar com dois servidores primários
    • Configuração de segurança para servidores em replicação
      Um novo parâmetro, S6_USE_REMOTE_SERVER_CFG define se o ficheiro indicado pelo parâmetro REMOTE_SERVER_CFG será também usado para conexões que utilizem a opção s=6 do SQLHOSTS (para replicação). Se o parâmetros estiver a 1 o referido ficheiro será utilizado, caso contrário o comportamento antigo será o escolhido e o ficheiro a usar será $INFORMIXDIR/etc/hosts.equiv
  • Segurança
    • Suporte ao Global Security Kit (GSKit)
      Um novo parâmetros, GSKIT_VERSION, pode ser usado para definir a versão do Global Security Kit que se pretende usar. O Informix 11.70.xC4 incluí a versão 8, mas pode trabalhar com a versão 7
    • Utilizacão de um ficheiro para autenticar conexões de servidores numa rede segura
      Já mencionado atrás (S6_USE_REMOTE_SERVER_CFG)
  • Dados Time Series
    • IBM Informix TimeSeries Plug-in para Data Studio
      Este novo plugin permite interagir com dados TimeSeries a partir do Optim Data Studio e do Optim Developer Studio
    • Apagar um intervalo de elementos e libertar páginas vazias de um time series
      Melhorias nos DELETEs em dados TimeSeries que permitem libertar espaço
    • Agregar dados time series cruzando várias linhas
      Melhorias na forma como podemos agregar informação guardada em TimeSeries
Para além de trazer algumas novas funcionalidades, esta versão também corrige alguns bugs importantes em torno da funcionalidade de read ahead automático introduzido na versão 11.70.xC3. Fora isto, julgo que é importante salientar os seguintes pontos:


  • O TimeSeries continua a receber muito do foco das últimas melhorias no Informix. Isto é expectável e desejável considerando as boas notícias sobre histórias de sucesso e o recente benchmark
  • O novo health plugin do OAT. Não tive muito tempo ainda para o explorar, mas certamente faria algumas coisas de forma diferente, como por exemplo re-utilizar a configuração do ALARMPROGRAM para o envio de alarmes. Mas a criação deste plugin é uma óptima ideia e sendo um plugin pode ser alterado facilmente para se ajustar às nossas necessidades
  • A inclusão do OAT dentro do Client SDK é um bom passo (do meu ponto de vista). Torna ainda mais fácil obter e instalar o OAT. Já o instalei em Windows aproveitando o upgrade de versão que fiz ao Client SDK
  • A possibilidade de mudar dinamicamente mais parâmetros é excelente. Naturalmente que gostaria que todos os parâmetros da instância tivessem esta capacidade. Mas estamos cada vez mais perto. Os meus próximos favoritos seriam (e porquê):
    • LOGBUFF, PHYSBUFF
      Depois de uma análise a uma instância, muitas vezes estes devem ser mudados.
      Imagino que torná-los dinâmicos não fosse muito difícil, pois existem vários buffers que são usados de forma circular. Assim, após um pedido de mudança, quando passa de um para outro podia aproveitar-se para fazer a alteração. O LOGBUFF seria mais difícil pela importância que tem na replicação (HDR)
    • TBLSPACE_STATS
      Também aqui é uma boa práctica ter este parâmetro activo. Mas se for detectado que não está, ter de parar a instância para o mudar não é simpático
    • SYSSBSPACENAME, SBSPACENAME
      Muitas vezes estes não são definidos, mas a decisão de usar novas funcionalidades torna-os necessários. Mais uma vez, obrigar a paragem não é simpático...
    • CLEANERS
      Muitas vezes necessita ser alterado após uma análise à configuração e comportamento da instância
    • SHMTOTAL
      Muitos clientes não o definem. E por vezes podemos ter de reduzir ou aumentar o valor (os novos sistemas operativos já permitem adicionar/remover memória dinamicamente). Naturalmente não seria possível baixar o valor abaixo da quantidade já em uso
    • DD_*, DS_*, PC_*, PLCY_*, USRC_
      Mais candidatos habituais a mudança após uma análise de configuração. Estes seriam possivelmente dos mais complexos de tornar dinâmicos, mas se já se faz para a statement cache deveria ser possível fazer para estes também. Para além disso, uma funcionalidade para limpar uma das caches (ou pelo menos remover alguma entrada) seria útil em determinadas situações
    • EXT_DIRECTIVES
      Alguns clientes descobrem que precisam de o usar, mas está desligado por default. E uma paragem nunca é desejável
    • DBCREATE_PERMISSION
      Este é a meu ver dinâmico por natureza


Tuesday, May 11, 2010

Electrifying news?!

In the latest post of Guy Bowerman's blog I noticed a new case study about Informix. You can choose to read about it in the IBM website, or on the consulting company who did it website.
Hildebrand worked together with IBM labs (Hursley) in order to achieve real-time collection and analysis of detailed energy usage using commodity hardware.
This involves loading around 50000 events per second into the database. This is the estimate needed to support three million homes.
An innovative component of Informix was used: Timeseries Datablade
Timeseries is a datablade designed to load and handle massive amount of data which is time related. Any kind of repetitive measure along a timeline is what we're talking about, and apparently that was essential to this project. Datablades are pieces of software that work like plugins which extend the basic Informix functionality.